Hur lagren brons, silver och guld ger tillförlitlig rapportering i ett lakehouse, med exempel från verkliga dataflöden.
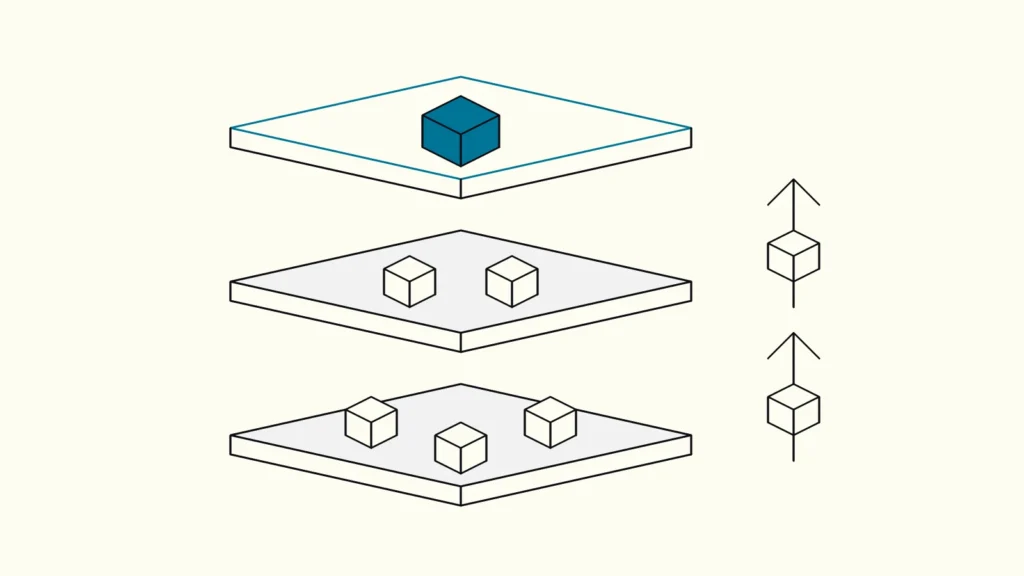
Medallion architecture är ett sätt att organisera data i ett lakehouse i tre lager. Brons sparar källdata precis som den kom in, silver tvättar, validerar och kopplar ihop den, och guld publicerar vyer byggda för bestämda affärsfrågor. Värdet ligger i en spårbar väg från en post i källsystemet till siffran i rapporten, med tydliga regler vid varje överlämning.
Den här guiden kommer från Devies, en produkt- och teknikkonsult i Göteborg som bygger och driver dataplattformar åt nordiska företag. Både Databricks och Microsoft Fabric beskriver mönstret i sin dokumentation, och implementationerna skiljer sig åt. Se det därför som ett sätt att fördela arbetet, inte som en färdig ritning.
Varför dela upp data i lager?
Lager gör det möjligt att svara på frågan "var kommer den här siffran ifrån?", eftersom varje steg har ett enda jobb och sin egen kopia av datan.
De flesta rapportproblem orsakas inte av själva rapporten. De kommer från en beräkning som tyst tappade poster, en källa som bytte format eller två team som tillämpar olika regler på samma data. När allt sker i ett enda steg mellan källsystemet och rapporten finns inget att jämföra med när en siffra ser fel ut.
En lagerindelning ger er kontrollpunkter. Om en intäktssiffra inte stämmer kan ni undersöka om källan levererade rätt poster (brons), om tvätt och matchning gick fel (silver) eller om affärsregeln i sig är fel (guld). Databricks beskriver lagren som nivåer av datakvalitet i lakehouset, och det är en användbar bild: kvaliteten ökar ju längre upp datan kommer.
Namnen på lagren gör dock ingen siffra korrekt. Utan överenskomna regler för varje överlämning kan en plattform ha tre prydligt namngivna mappar och samma rapportproblem som förut.
Vad hör hemma i varje lager i medallion architecture?
Brons innehåller rå källdata, silver innehåller validerad och sammankopplad data på postnivå, och guld innehåller affärsanpassade vyer som besvarar definierade frågor.
Brons: behåll utgångsläget
Brons är landningslagret för källdata, lagrad som den togs emot tillsammans med sammanhang som källsystem, uttagstid och laddnings-id. Här sker minimalt med transformation. Syftet är bevisning: om en rapport ifrågasätts kan teamet visa vad källan faktiskt levererade för perioden. Regler för lagringstid och åtkomst gäller ändå, så "rå" betyder inte att varje fält med personuppgifter sparas för alltid.
Silver: gör datan användbar över systemgränserna
I silver blir tvätt och validering uttryckliga. Typiskt arbete är enhetliga datatyper, hantering av dubbletter, mappning av id:n mellan system och kontroll av poster mot överenskomna regler. Silver ska behålla data på postnivå i stället för att aggregera den. Poster som inte klarar en kontroll ska synas i en undantagslista, inte försvinna i det tysta.
Guld: besvara en affärsfråga
Guld är en uppsättning kurerade tabeller eller vyer organiserade kring en överenskommen fråga, till exempel fakturerad intäkt per kund och månad. Det är lagret som dashboards, ekonomirapporter och AI-tjänster läser från. Varje guldtabell behöver en dokumenterad granularitet, till exempel en rad per fakturarad, och namngivna ägare för sina definitioner.
Lager
Ansvar
Exempel på acceptanskontroll
Brons
Ansvar
Ta emot källuttaget oförändrat, med laddningsmetadata
Exempel på acceptanskontroll
Laddningen är klar med registrerad brytpunkt i källan
Silver
Ansvar
Tvätta, ta bort dubbletter och matcha poster mellan system
Exempel på acceptanskontroll
Dubbletter och omatchade poster räknas och rapporteras
Guld
Ansvar
Publicera en överenskommen affärsvy
Exempel på acceptanskontroll
Summorna stämmer mot källan för en definierad period
Data lake vs data warehouse: var passar ett lakehouse in?
Ett lakehouse kombinerar den billiga och flexibla lagringen i en data lake med strukturen och tillförlitligheten i ett data warehouse, och medallion architecture är det vanligaste sättet att organisera datan där inne.
Begreppen används ofta slarvigt, så tydliga definitioner hjälper:
- En data lake är billig lagring för stora datamängder i ursprungligt format, strukturerat eller inte. Den är flexibel men svår att lita på för rapportering om disciplinen saknas.
- Ett data warehouse är en strukturerad databas byggd för analys, med definierade tabeller, scheman och affärsregler. Det är pålitligt för rapportering men mindre flexibelt för nya eller ostrukturerade källor.
- Ett lakehouse är en plattform som lagrar data i öppna format på lake-lagring och samtidigt lägger till warehouse-funktioner som tabeller, transaktioner och åtkomststyrning.
Data lake
Data warehouse
Lakehouse
Dataformat
Data lake
Valfritt, som det kom in
Data warehouse
Strukturerade tabeller
Lakehouse
Öppna tabellformat på lake-lagring
Typisk användning
Data lake
Lagring, data science, arkiv
Data warehouse
BI och finansiell rapportering
Lakehouse
Båda, på en plattform
Styrka
Data lake
Flexibilitet och kostnad
Data warehouse
Konsekvens och prestanda
Lakehouse
Kombinerar båda om det styrs väl
Största risk
Data lake
Blir ett "dataträsk"
Data warehouse
Långsamt att lägga till nya källor
Lakehouse
Komplexitet utan tydliga lagerregler
I diskussionen om data lake vs data warehouse är det lagren som överbryggar skillnaden. Brons beter sig som en klassisk data lake, medan guld beter sig ungefär som ett data warehouse. Ni behöver inte alltid tre separata tekniker. Mönstret beskriver ansvar, och hur den fysiska uppdelningen ser ut beror på plattform och åtkomstbehov. Vill ni gå djupare i valet av arkitektur finns vår guide data lakehouse eller data warehouse.
Governance: vem äger vilket lager?
Varje överlämning mellan lager behöver en namngiven ägare, överenskomna kvalitetsregler och ett krav på aktualitet, annars finns lagren bara på papperet.
Det tekniska ägarskapet ligger oftast hos dataingenjörer för brons och silver. Definitionerna i guld, till exempel vad som räknas som "intäkt" eller "aktiv kund", behöver en ägare i verksamheten som kan avgöra vad som är rätt. När två avdelningar ser olika siffror för samma mått beror det oftast på två definitioner på två ställen. Det problemet går vi igenom i artikeln om varför Power BI visar olika siffror för ekonomi och sälj.
Praktiska frågor att avgöra tidigt:
- Vem får köra om en laddning, och hur upptäcks ofullständiga laddningar?
- Vad händer när en kontroll i silver fallerar: sätts posten i karantän, eller stoppas uppdateringen av rapporten?
- Hur färsk måste datan i guld vara, och hur ser användarna att den är inaktuell?
- Var bor återanvändbara affärsregler: i guldtabellerna eller i den semantiska modellen i Power BI? Microsofts vägledning om stjärnschema för Power BI förklarar varför modellen ändå behöver riktiga relationer och mått.
- Vem godkänner ändringar av en definition i guld, och hur får rapportanvändarna veta det?
Ett exempel: från faktura i affärssystemet till intäktsrapport
Ett enkelt, påhittat intäktsflöde visar hur lagren delar upp arbetet mellan data från affärssystem och CRM och en månadsrapport.
Brons tar emot fakturarader från affärssystemet och kundposter från CRM varje natt, var och en märkt med laddningstid. Silver standardiserar valutor och datum, tar bort dubblerade fakturarader och mappar kund-id:n i affärssystemet mot konto-id:n i CRM. Konton som inte går att matcha hamnar i en undantagslista som säljstödet går igenom varje vecka. Guld publicerar fakturerad intäkt per kund, segment och månad, med kreditfakturor och valutaregler dokumenterade. Power BI läser från guld, och ekonomi och sälj använder samma tabell.
Om en säljchef ifrågasätter en siffra kan teamet följa den bakåt: summan i guld, posterna i silver bakom den och uttaget i brons för perioden.
Samma principer fungerar i större, etablerade plattformar. I kundcaset med Stena Line beskriver Devies hur en befintlig dataplattform på Azure flyttades mot lagerindelade flöden i medallion-stil, med kontrollerade och spårbara transformationer, medan den befintliga rapporteringen fortsatte att fungera. Caset anger ungefär 25 procent kortare körtid för pipelines, men den siffran gäller just den plattformen och är inget resultat som varje organisation ska räkna med.
En liten rapport från en enda pålitlig källa behöver inte alltid tre lager. Flera källor, återkommande kvalitetsproblem och flera konsumenter av samma data är starkare skäl att införa mönstret.
Läs vidare
Från vårt arbete
 Client Case: StadsbyggnadsförvaltningenHow Devies helped Gothenburg's city planning office turn fragmented traffic data into a living, trusted Traffic Catalogue.Läs caset
Devies
Vill ni ha en second opinion?
Devies, en produkt- och utvecklingskonsult i Göteborg, arbetar med frågor som den här tillsammans med nordiska produkt- och IT-team. Berätta var ni står så föreslår vi ett rimligt första steg.
Vanliga frågor
Vad är medallion architecture, enkelt förklarat?
Medallion architecture är ett sätt att organisera data i tre lager. Brons sparar data exakt som den kom från källsystemen, silver tvättar, validerar och kopplar ihop den, och guld publicerar tabeller byggda för bestämda affärsfrågor. Varje lager har ett enda jobb, så när en rapport ser fel ut kan teamet följa siffran bakåt steg för steg och hitta var felet uppstod.
Är guldlagret samma sak som en dashboard i Power BI?
Nej. Guld är ett förberett datalager, medan en dashboard är en presentation byggd ovanpå data och en semantisk modell. Flera rapporter, verktyg och AI-tjänster kan läsa från samma guldtabeller. Genom att hålla dem isär implementeras en affärsdefinition en gång, i guld eller i en gemensam modell, i stället för att upprepas på olika sätt i varje enskild rapport.
Behöver vi ett lakehouse för att använda medallion architecture?
Inte nödvändigtvis. Mönstret beskrivs oftast för lakehouse-plattformar som Databricks och Microsoft Fabric, men idén att skilja rå, validerad och affärsanpassad data åt fungerar även i ett traditionellt data warehouse. Det viktiga är att varje steg har tydligt ansvar, kvalitetskontroller och ägare, inte vilken lagringsteknik som ligger under.