Så kontrollerar ni om företagets data klarar ett bestämt AI-flöde, innan ni kopplar en modell till den.
AI readiness, att vara redo för AI, gäller en uppgift och inte ett helt företag. Era data är redo för ett visst AI-flöde när en ägare kan peka ut de auktoritativa källorna, begreppen betyder samma sak i alla system, indata är tillräckligt färska, behörigheterna håller genom hela kedjan och ni kan testa svaren mot förväntade svar. Kontrollera de fem sakerna innan ni kopplar in en modell.
Många medarbetare använder redan AI-verktyg på egen hand. Att koppla AI till företagets processer väcker svårare frågor: vilken post som är aktuell, vem som får se den och vad "kund" eller "order" betyder i olika system. Det kan ingen modell avgöra åt er. Guiden kommer från Devies, ett produkt- och utvecklingskonsultbolag i Göteborg, och ger CTO:er och dataansvariga ett praktiskt sätt att bedöma om datan är redo för ett utvalt flöde. Då börjar AI-utvecklingen i belägg i stället för i optimism.
Vad betyder AI readiness?
AI readiness är i vilken grad ett definierat AI-flöde kan få tillgång till relevant och tillräckligt pålitlig data, respektera behörighetsregler och ge svar som någon kan utvärdera. Ett företag kan samtidigt vara redo för en intern dokumentassistent och oförberett för automatiserade kassaflödesprognoser, eftersom uppgifterna bygger på olika data.
Begreppet blandas ofta ihop med närliggande idéer. Håller ni isär dem blir det lättare att ställa rätt fråga:
Begrepp
Vad det är
Frågan det besvarar
AI readiness
Vad det är
Hur väl viss data och vissa processer passar en AI-uppgift
Frågan det besvarar
Kan det här flödet fungera säkert med den data vi har?
Datamognad (data maturity)
Vad det är
Den allmänna nivån på datahanteringen i organisationen
Frågan det besvarar
Hur väl hanterar vi data överlag?
AI-strategi
Vad det är
Valet av var AI ska skapa värde och i vilken ordning
Frågan det besvarar
Vilka AI-användningar är värda att göra först?
Modellprestanda
Vad det är
Hur väl en modell svarar på en testuppsättning
Frågan det besvarar
Är modellen tillräckligt bra för uppgiften?
Hög datamognad gör det lättare att bli redo, men är inget krav. En liten dokumentsamling med tydlig ägare kan bära en användbar pilot i ett företag vars övriga data är rörig. Det omvända gäller också: en mogen dataplattform gör inte en otydlig uppgift redo. Vilken uppgift ni ska börja med är en strategifråga; guiden om hur ni prioriterar AI-användningsfall visar hur ni poängsätter dem.
Sju steg för att kontrollera om era data är redo för AI
Kontrollera beredskapen genom att följa en verklig uppgift från fråga till källa och testa varje länk i kedjan. Stegen tar några arbetspass med dem som äger datan, inte en granskning som pågår i månader.
- Välj en uppgift och formulera den snävt. "Svara på kundansvarigas frågor om godkända produktspecifikationer" går att testa. "Gör vår kunskap tillgänglig för AI" gör det inte.
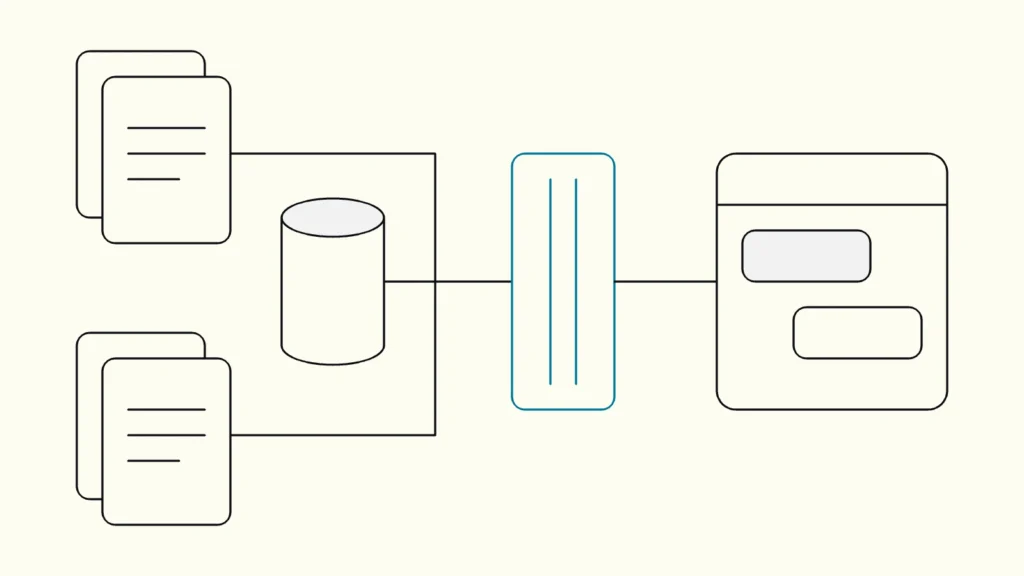
- Följ typiska frågor tillbaka till källorna. Ta reda på var svaret finns för varje fråga, vem som underhåller det och hur det skulle nå AI-applikationen. Gör samma sak för ett undantag, till exempel en produkt med ändrad specifikation.
- Utse en ägare för varje källa. Någon måste avgöra vilken version som gäller, lösa oenigheter och godkänna rättelser. Utan ägare förblir två "slutliga" dokument på en delad disk just två.
- Kom överens om definitionerna uppgiften bygger på. Sälj kan räkna ett signerat avtal som en kund medan ekonomi räknar en fakturerad juridisk person. Båda är rimliga, men svaret måste ange vilken definition det använder. Ett kort register över identifierare, statusvärden, tidsstämplar och beräkningsregler räcker.
- Bestäm hur gammal varje indata får vara. En uppdatering över natten kan räcka för gårdagens försäljning men vara värdelös för ett lagersaldo som ändras under dagen. Kontrollera hela vägen, eftersom en aktuell källa inte garanterar ett aktuellt sökindex.
- Testa behörigheterna hela vägen. Att tekniskt kunna läsa en databas är inte samma sak som att få visa innehållet för alla användare. Testa med ett vanligt konto som medvetet har begränsad åtkomst, och ta med konversationsloggarna i granskningen.
- Bygg en liten utvärderingsuppsättning före utrullning. Samla representativa frågor med förväntade svar, även frågor där det inte finns något godkänt svar. Utan den kan ni inte avgöra om en ändring i data eller modell gjorde saken bättre eller sämre.
Hur bra måste datan vara?
Datan måste vara tillräckligt bra för konsekvensen av ett misstag, inte perfekt. Vilken kvalitet som krävs beror på vilket beslut svaret stöder och på om en människa granskar resultatet innan det får betydelse.
För en kunskapsassistent kontrollerar ni att dokumenten är aktuella, läsbara och tydligt kopplade till ett ämne. För en prediktiv modell kan ni behöva konsekvent historik och etiketter. Mät de problem som blockerar uppgiften: en saknad produktidentifierare kan stoppa sökningen, medan en saknad frivillig beskrivning kanske inte gör det. Notera hur ofta varje blockerande problem förekommer och vem som kan åtgärda det. "Vår datakvalitet är dålig" ger ett leveransteam ingenting att arbeta med. "12 procent av de aktiva produkterna saknar leverantörskod, och inköp äger den" gör det.
Microsoft beskriver retrieval augmented generation i Azure AI Search som ett sätt att ge en språkmodell relevant information från ert eget innehåll. Sökningen hjälper, men den avgör inte på egen hand vilka dokument som passar för varje medarbetare. Det beslutet vilar fortfarande på steg 3 till 6.
Vad förväntar sig regelverk och riskramverk av er data?
För det mesta AI-arbetet i företag sätter ingen lag en gräns för datakvalitet, men EU:s AI-förordning gör det för högrisksystem, och frivilliga ramverk ger en användbar struktur för alla andra.
Artikel 10 i EU:s AI-förordning kräver att data för träning, validering och testning av AI-system med hög risk omfattas av rutiner för datastyrning och datahantering som passar det avsedda ändamålet. I oktober 2026 anger Europeiska kommissionens sida om AI-förordningen att sedan Digital Omnibus on AI trädde i kraft den 27 juli 2026 gäller högriskreglerna för användningar i bilaga III, som rekrytering och kreditprövning, från den 2 december 2027, och för AI i reglerade produkter från den 2 augusti 2028.
Utanför högriskkategorierna är NIST AI Risk Management Framework, som släpptes i januari 2023, en frivillig referens uppbyggd kring fyra funktioner: govern, map, measure och manage. Betoningen på att känna sitt sammanhang och mäta utfall stämmer med de sju stegen ovan. Använd det för att strukturera er AI-strategi och er riskdiskussion, inte som ett certifikat.
Ett exempel: en assistent för interna produktfrågor
Ett genomarbetat exempel visar hur problem med beredskapen oftast visar sig vara data- och ägarskapsproblem, inte modellproblem. Fallet är påhittat och gäller ingen kund till Devies.
En grossist vill ha en assistent som svarar på säljteamets frågor om en produktfamilj. En produktägare tar bort inaktuella versioner och bekräftar vilka specifikationer som gäller. Teamet skriver trettio frågor med förväntade svar, varav fem där det inte finns något godkänt svar.
Det första testet visar att dokumenten använder två olika format för produktkoder, så assistenten missar hälften av de relevanta filerna. Att rätta den mappningen förbättrar resultatet mer än ett modellbyte skulle ha gjort. Ett test med en användare med begränsad åtkomst visar sedan att leverantörsavtal hade indexerats tillsammans med offentliga specifikationer. De dokumenten tas bort tills någon har bestämt vem som får se dem. Först därefter breddas piloten till en andra produktfamilj.
Läs vidare
Från vårt arbete
 Client Case: Stena LineStena Line modernised its Azure data platform - improving Power BI reliability, reducing pipeline runtimes and scaling with medallion architecture.Läs caset
Devies
Vill ni ha en second opinion?
Devies, en produkt- och utvecklingskonsult i Göteborg, arbetar med frågor som den här tillsammans med nordiska produkt- och IT-team. Berätta var ni står så föreslår vi ett rimligt första steg.
Vanliga frågor
Måste vi tvätta all data innan vi börjar med AI?
Nej. Börja med den indata som ett definierat flöde behöver, rätta de problem som påverkar resultatet och bredda när det finns ett skäl. En städning av hela företagets data har ingen naturlig slutpunkt och fördröjer lärandet. Beredskapen för en uppgift går att mäta inom några veckor, medan ett allmänt program för datakvalitet kan pågå i åratal utan att visa om AI fungerar för er.
Hur mäter vi AI readiness?
Mät per uppgift med fem kontroller: finns en namngiven ägare för varje källa, är nyckelbegreppen definierade, är datan tillräckligt färsk för beslutet, håller behörigheterna från källa till svar, och finns en utvärderingsuppsättning med förväntade svar? Dokumentera belägg för varje kontroll. En uppgift som klarar alla fem är redo för en pilot, och luckorna blir en konkret att göra-lista.
Hindrar retrieval augmented generation att AI svarar fel?
Sökningen minskar risken genom att ge modellen relevant källmaterial, men den tar inte bort den. Svaren kan fortfarande bli fel om källorna är inaktuella, motsäger varandra eller hämtas dåligt, eller om modellen läser dem fel. Ni behöver fortfarande källhänvisningar, en utvärderingsuppsättning, hantering av frågor utan godkänt svar och behörighetskontroll av det som hämtas.
Är en lyckad prototyp ett bevis på att datan är redo?
Inte i sig. En prototyp visar att vissa uppgifter fungerade under de förhållanden som testades, ofta med välvilliga användare och rena exempel. Upprepa testerna med realistiska användare och behörigheter, undantag, data som ändras och frågor som ska avvisas innan ni skalar upp. Beredskapen är bevisad när utvärderingsuppsättningen klarar sig under produktionslika förhållanden, inte när en demo imponerar.