Orsakerna bakom motstridiga KPI:er och hur ett gemensamt datalager och masterdata ger en enda version av sanningen.
När Power BI visar olika siffror för ekonomi och sälj beror det sällan på att verktyget räknar fel. Oftast mäter rapporterna olika saker under samma namn, använder olika datum eller filter, eller hämtar data från olika källor och vid olika tidpunkter. Lösningen är gemensamma definitioner, ett delat semantiskt lager och masterdata som alla rapporter bygger på, inte en ny dashboard.
Det besvärliga är att båda rapporterna kan fungera precis som de är byggda. Sälj räknar kanske bekräftade order, medan ekonomi räknar bokförda fakturor. Det är två olika affärshändelser. När båda kallas "intäkter" ser skillnaden ut som ett tekniskt fel.
Symptom: så märks det att siffrorna inte går ihop
De flesta organisationer känner igen mönstret:
- Ledningsgruppen får två olika svar på frågan om hur mycket som sålts förra månaden.
- Varje Power BI dashboard har sin egen variant av samma KPI, med små skillnader i filter eller beräkning.
- Analytiker lägger tid på att stämma av siffror i Excel innan de vågar presentera dem.
- Kundantalet skiljer sig mellan CRM-rapporten och ekonomirapporten.
- Ingen kan svara på vem som äger definitionen av ett visst nyckeltal.
Ett hypotetiskt exempel: sälj rapporterar 1,2 miljoner kronor i order som accepterades i september. Ekonomi rapporterar 980 000 kronor i septemberfakturor. En del order är ännu inte fakturerade, och en del septemberfakturor gäller augustiorder. Ingen av summorna bevisar att något är fel. Det som saknas är en brygga mellan dem och ett beslut om vilket mått som ska användas i vilket sammanhang.
Grundorsaker till motstridiga KPI:er
Olika definitioner
Den vanligaste orsaken är att samma ord betyder olika saker. Ingår moms, krediteringar och avbokningar i "intäkt"? Vilket datum placerar en affär i en period: orderdatum, leveransdatum eller fakturadatum? Hur hanteras valutaomräkning? Så länge detta inte är nedskrivet bygger varje rapportförfattare sin egen tolkning.
Olika filter och behörigheter
Två personer som tittar på samma rapport kan ändå se olika populationer. Utsnitt, sidfilter, visuella filter och korsfiltrering påverkar resultatet. Radnivåsäkerhet kan dessutom göra att en säljchef bara ser sin region medan controllern ser hela bolaget.
Olika uppdateringstider
En importerad Power BI-modell innehåller data från senaste uppdateringen. En lyckad uppdatering betyder inte att källan redan hade fått alla poster. Om CRM-exporten blir klar 06.10 och rapporten uppdateras 06.00 visar rapporten gårdagens läge utan att någon märker det. Microsofts dokumentation om datauppdatering beskriver skillnaden mellan att uppdatera data och att uppdatera visualiseringar.
Olika kopplingar och granularitet
En affärsmöjlighet i CRM är inte en fakturarad i ERP. Om tabeller kopplas via ett kundfält som inte är unikt kan samma belopp räknas flera gånger. Microsofts vägledning om stjärnschema och relationer i Power BI förklarar varför fakta, dimensioner och konsekvent granularitet påverkar totalerna.
Checklista för att felsöka en avvikelse
Jämför ett mått i taget och dokumentera:
Kontroll
Vad ni samlar in
Mått
Vad ni samlar in
Måttets namn och skriftlig affärsdefinition
Population
Vad ni samlar in
Bolag, kunder, produkter och statusar som ingår
Period
Vad ni samlar in
Datumfält, intervall och regel för periodstängning
Rapport
Vad ni samlar in
Publicerad version, arbetsyta och semantisk modell
Behörighet
Vad ni samlar in
Användarroll och eventuell radnivåsäkerhet
Aktualitet
Vad ni samlar in
Tidpunkt för senaste lyckade källaddning och modelluppdatering
Stäm därefter av mot enskilda poster, till exempel faktura-id, för en liten och avgränsad period. En lista över saknade eller dubblerade poster säger mer än två skärmbilder med olika totaler.
Ett semantiskt lager med gemensamma mått
När en avvikelse återkommer i flera rapporter räcker det inte att rätta en rapport i taget. Då behövs ett semantic layer, ett semantiskt lager där affärsbegreppen definieras en gång: vad en kund är, hur nettoomsättning räknas och vilket datum som styr perioden.
I Power BI motsvaras detta ofta av en delad semantisk modell som flera rapporter bygger på. Microsoft beskriver hur en semantisk modell kan delas med behörigheten Build, så att andra kan skapa rapporter på samma mått utan att bygga om dem. Vinsten är att "orderingång" och "fakturerad intäkt" blir två tydligt namngivna mått i stället för två konkurrerande tolkningar av "intäkt".
Ett delat lager kräver styrning:
- En utsedd ägare per mått, oftast i verksamheten, inte i IT.
- En process för att ändra definitioner, med test mot ett överenskommet facit.
- Tydlig separation mellan certifierade mått och lokala experiment.
Alla domäner behöver inte samma modell. Ekonomi och marknad kan ha goda skäl att ha separata modeller, så länge de gemensamma begreppen kommer från samma källa.
Masterdata: samma kund, produkt och organisation överallt
Även med gemensamma mått blir siffrorna fel om grunddata skiljer sig mellan systemen. Masterdata är de gemensamma referensdata som affären vilar på: kunder, produkter, artiklar, organisationsenheter och kontoplan.
Typiska problem är att CRM organiserar kunder efter säljrelation medan ERP utgår från juridiska fakturamottagare, att samma produkt har olika koder i olika system, och att organisationsförändringar slår igenom i ett system men inte i ett annat.
Börja smalt. Välj den masterdata som orsakar flest avvikelser, ofta kund, och gör följande:
- Bestäm vilket system som är ledande för varje attribut.
- Skapa en uttrycklig mappning mellan systemens nycklar i stället för att matcha på namn.
- Visa omatchade poster i en undantagslista som någon ansvarar för.
- Utse en ägare som beslutar om dubbletter och sammanslagningar.
Ett fullständigt MDM-program är sällan första steget. En väl underhållen mappning för kund och produkt i datalagret löser ofta en stor del av avvikelserna.
Ett gemensamt datalager som grund för business intelligence
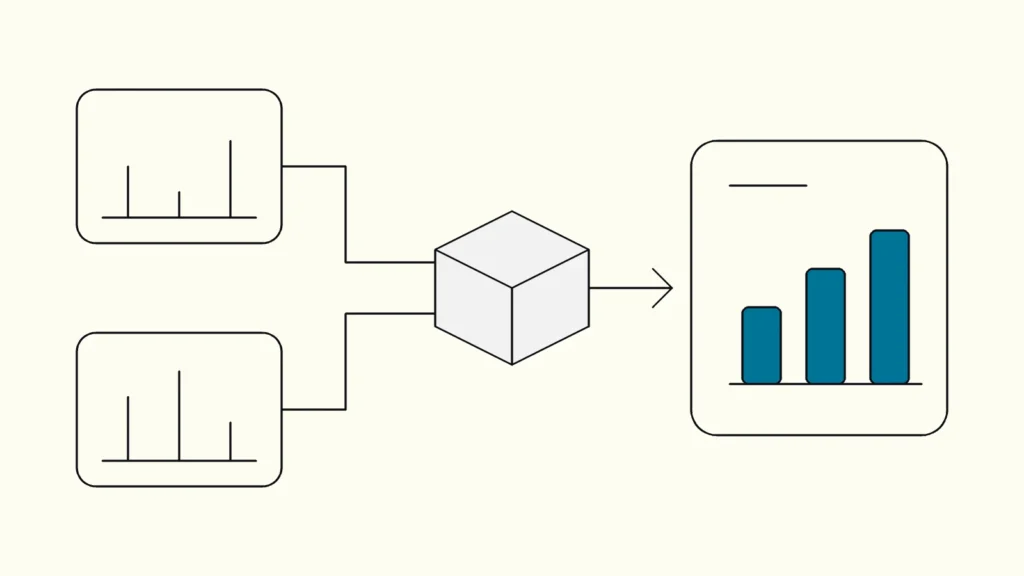
Semantiskt lager och masterdata behöver en plats att leva på. Ett gemensamt datalager samlar data från ERP, CRM och ekonomisystem, tvättar och kopplar ihop den och levererar beslutsfärdig data till Power BI och andra verktyg.
Ett vanligt sätt att strukturera det är i tre nivåer: rådata som den kom från källan, tvättad och sammanförd data, och beslutsfärdig data med gemensamma mått. Fördelen för business intelligence är spårbarhet. När en siffra ifrågasätts kan ni följa den bakåt till källposten och se vilken regel som påverkade den.
Viktigt att komma ihåg:
- Rätta den minsta orsaken först. Ett dolt filter kräver en rapporträttning, inte en ny plattform.
- Spara ett facit: förväntat resultat, källposter och beräkningsregel, så att samma fråga kan kontrolleras efter framtida ändringar.
- Visa tydligt i rapporten vilken period den täcker och när källdata senast laddades.
Läs vidare
Från vårt arbete
 Client Case: CetasolHow Devies helped Cetasol modernise iHelm, improve data quality and build new features for AI-driven fuel optimisation in marine operations.Läs caset
Devies
Vill ni ha en second opinion?
Devies, en produkt- och utvecklingskonsult i Göteborg, arbetar med frågor som den här tillsammans med nordiska produkt- och IT-team. Berätta var ni står så föreslår vi ett rimligt första steg.
Vanliga frågor
Varför visar två Power BI-rapporter olika totaler?
De använder ofta olika definitioner, filter, modeller eller uppdateringstider. Jämför dem först och stäm sedan av mot källposter för en liten, överenskommen period.
Behöver alla rapporter använda samma semantiska modell?
Inte nödvändigtvis. En delad modell hjälper rapporter att använda samma mått, men den kräver ägarskap och kontrollerade ändringar. Separata domäner kan ha egna modeller så länge gemensamma begrepp kommer från samma källa.
Måste vi bygga en ny dataplattform för att få en sanning?
Nej. Ett lokalt filter- eller beräkningsfel kan rättas i befintlig rapport. Återkommande avvikelser mellan flera system är däremot ett tecken på att ni behöver gemensamma definitioner, masterdata och ett gemensamt datalager.
Källor
- Microsoft Learn, Data refresh in Power BI
- Microsoft Learn, Understand star schema and the importance for Power BI
- Microsoft Learn, Model relationships in Power BI Desktop
- Microsoft Learn, Share access to a semantic model
- Devies, Data Hub
- Devies, Client case Stena Line
- Devies, Data and AI Use Case Discovery Workshop