Var transformationen ska ske, vilka typer av verktyg som gör vilken del av jobbet och frågorna som skiljer ett verktyg som passar från en bra demo.
ETL transformerar data i en separat motor innan den laddas in i målet. ELT laddar in rådata först och transformerar den inne i datalagret eller lakehouse-plattformen. ELT passar moderna molnplattformar som sparar rå historik, ETL passar mål med begränsad kapacitet och strikta kontroller före laddning. Välj ETL-verktyg utifrån era källor, er målplattform, teamets kompetens och hur ändringar testas.
Varje analysplattform är beroende av en datapipeline som flyttar data ut ur affärssystem, CRM, ekonomisystem och operativa system. Det första designvalet är var datan formas om. Det andra är vilka ETL-verktyg som sköter flytten, omformningen och schemaläggningen. Jämförelsen kommer från Devies, ett produkt- och utvecklingskonsultbolag i Göteborg, och är skriven för dataansvariga och CTO:er som ska välja eller byta ut sin lösning för dataintegration och vill förstå avvägningarna innan de pratar med leverantörer.
Vad är ETL och ELT?
ETL och ELT är två ordningar av samma tre steg, extrahera, transformera och ladda, och den enda verkliga skillnaden är var transformationen körs.
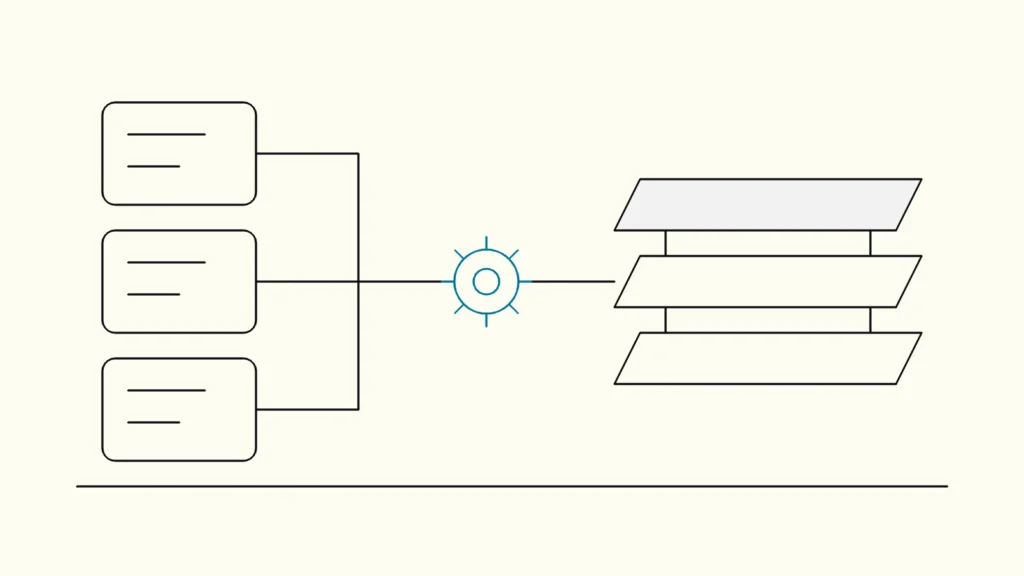
ETL (extract, transform, load) är en process för dataintegration där data extraheras från källorna, transformeras i en särskild motor, ofta via mellanlagringstabeller, och sedan laddas in i målet. ELT (extract, load, transform) är en process där rådata laddas in i målet först och transformeras där, med målplattformens egen beräkningskapacitet.
Microsofts arkitekturguide om ETL och ELT säger det rakt ut: ELT skiljer sig från ETL enbart i var transformationen sker. Utan den separata motorn blir arkitekturen enklare, och när målet skalas skalas också pipelinen, men ELT fungerar bara bra om målet kan transformera data effektivt.
Två närliggande begrepp dyker upp i samma diskussioner. Reverse ETL flyttar modellerad data från datalagret tillbaka till operativa verktyg, till exempel CRM-systemet. Change data capture (CDC) läser bara de rader som har ändrats i en källdatabas, i stället för att kopiera hela tabeller varje gång.
ETL vs ELT: hur skiljer de sig åt?
Valet mellan ETL och ELT handlar om var kontrollen och beräkningskapaciteten ligger. För de flesta företag som bygger på ett datalager eller lakehouse i molnet i dag är ELT utgångsläget, och ETL används i särskilda fall.
Kriterium
ETL
ELT
Var transformationen körs
ETL
I en separat motor före målet
ELT
Inne i datalagret eller lakehouse-plattformen
Rådata sparas i målet
ETL
Oftast inte
ELT
Ja, vilket gör det möjligt att bygga om och hitta nya användningar
Belastning på målsystemet
ETL
Låg
ELT
Högre, kräver elastisk beräkningskapacitet
Typiskt språk för transformationer
ETL
Verktygsspecifikt, ofta visuella mappningar
ELT
Mest SQL, ibland Python eller Spark
Känsliga uppgifter
ETL
Kan filtreras eller maskeras innan datan landar
ELT
Kräver behörighetsstyrning på rådatalagret
Ändringar och tester
ETL
I ETL-verktygets egen miljö
ELT
Versionshanterad kod med automatiska tester
Passar typiskt
ETL
Lokala datalager, mål med begränsad kapacitet, strikt granskning före laddning
ELT
Dataplattformar i molnet, medallion-arkitektur, växande analys
Välj ETL när målsystemet har begränsad beräkningskapacitet, komplexa regler kräver en specialiserad motor eller regelverk kräver att data filtreras, maskeras eller granskas i mellanlagringen innan den landar. Microsofts guide anger samma tre skäl.
Välj ELT när målet är ett modernt datalager eller lakehouse som skalar, ni vill spara rådata för framtida frågor och schemaändringar och teamet föredrar transformationer som kod. Med rådatalagret kvar kan en felaktig transformation dessutom rättas och köras om utan att ni behöver be källsystemet om en ny export.
Många plattformar i verkligheten är hybrider. Personuppgifter kan maskeras på vägen in (ett litet ETL-steg), medan affärslogiken körs i datalagret (ELT). Etiketten spelar mindre roll. Frågan är vilka regler som måste tillämpas innan datan landar och vilka som kan tillämpas efteråt.
Vilka typer av ETL-verktyg finns det?
ETL-verktyg delas in i fem kategorier, och en typisk lösning kombinerar två eller tre av dem i stället för att låta en produkt göra allt.
Kategori
Vad den gör
Exempel (enligt leverantörernas dokumentation)
Inläsning och replikering
Vad den gör
Kopierar data från källor till plattformen via färdiga anslutningar
Exempel (enligt leverantörernas dokumentation)
Airbyte, kopieringsjobb i Fabric Data Factory
Integrationstjänster
Vad den gör
Visuella pipelines som täcker extrahering, transformering och laddning i en tjänst
Exempel (enligt leverantörernas dokumentation)
AWS Glue, Azure Data Factory, SQL Server Integration Services
Transformation i datalagret
Vad den gör
"T" i ELT, skrivet som SQL-modeller med tester
Exempel (enligt leverantörernas dokumentation)
dbt, Databricks Lakeflow-pipelines, notebooks i Fabric
Change data capture
Vad den gör
Strömmar ändringar på radnivå från databaser
Exempel (enligt leverantörernas dokumentation)
Debezium, inbyggd CDC i vissa replikeringsverktyg
Orkestrering
Vad den gör
Schemalägger jobb, bestämmer ordningen och hanterar omförsök
Exempel (enligt leverantörernas dokumentation)
Apache Airflow, pipelines i Fabric Data Factory
Vissa tjänster spänner över flera kategorier. AWS beskriver Glue som en serverlös tjänst för dataintegration som klarar ETL, ELT och strömmande flöden i en och samma tjänst, och Microsoft Fabric samlar inläsning, pipelines och notebooks i en produkt. Paket ger färre leverantörer, separata verktyg ger större frihet att byta ut en del senare.
Att flytta data mellan operativa system, till exempel orderdata från en webbutik till affärssystemet, är ett annat jobb. Den sidan beskriver vi i jämförelsen av iPaaS och egna integrationer.
Hur väljer ni ETL-verktyg?
Ni väljer ETL-verktyg genom att testa dem mot era egna källor, er målplattform och ert team, inte mot en funktionslista. De nio frågorna nedan skiljer verktygen som passar från dem som bara ser bra ut i en demo.
- Vilka källor måste stödjas, och hur? Lista varje källsystem och kontrollera om det finns en underhållen anslutning, ett API eller en databaskoppling. Det är i nischade affärssystem och branschsystem som luckorna uppstår.
- Vilken målplattform har ni valt? Datalagret eller lakehouse-plattformen avgör mycket av resten. Välj plattformen först, och sedan verktyg som fungerar direkt med den.
- Hur mycket data ändras, och hur ofta? Fullständiga omladdningar är enkla men blir långsammare för varje år. Kontrollera stödet för inkrementell laddning och CDC. Vår artikel om realtidsdata eller batch hjälper er att avgöra hur färsk datan egentligen behöver vara.
- Vem ska bygga och underhålla pipelines? Visuella verktyg passar team utan utvecklare, kodbaserade verktyg passar team som redan använder Git, kodgranskning och tester.
- Kan ändringar versionshanteras och testas före produktion? Om en pipeline bara kan redigeras direkt i webbläsaren i produktion är varje ändring en risk.
- Hur upptäcks fel, och hur körs jobben om? Leta efter omförsök, larm, loggar och säkra omkörningar. Vår guide till datapipelines som inte går sönder listar arbetssätten att titta efter.
- Vart färdas datan och vem kan se den? Kontrollera driftregion, kryptering, behörighetsstyrning på rådata och om ett SaaS-verktyg sparar kopior av era data.
- Hur beräknas kostnaden? Prismodellerna skiljer sig: per rad, per anslutning, per beräkningstimme eller per användare. Räkna på era egna volymer över tre år i stället för att jämföra listpriser.
- Hur svårt är det att byta bort verktyget? Välj hellre verktyg som skriver till öppna format och håller transformationslogiken i läsbar kod som ni äger.
Gör ett kort konceptbevis med två av era riktiga källor, inklusive den rörigaste, och mät laddningstid, felhantering och hur lång tid en ändring tar.
Devies såg vad pipelinearbete kan betyda för en etablerad plattform hos Stena Line. Enligt caset integrerade samarbetet flera nya datakällor i datalagret, minskade pipelinens körtid med ungefär 25 procent och flyttade plattformen mot en medallion-arkitektur i Azure Data Lake, vilket gjorde det snabbare att ta in nya analytiska användningsfall.
Läs vidare
Från vårt arbete
 Client Case: CetasolHow Devies helped Cetasol modernise iHelm, improve data quality and build new features for AI-driven fuel optimisation in marine operations.Läs caset
Devies
Vill ni ha en second opinion?
Devies, en produkt- och utvecklingskonsult i Göteborg, arbetar med frågor som den här tillsammans med nordiska produkt- och IT-team. Berätta var ni står så föreslår vi ett rimligt första steg.
Vanliga frågor
Är ELT bättre än ETL?
Ingen av dem är bättre generellt. ELT passar oftast bättre när ni laddar in i ett datalager eller lakehouse i molnet med elastisk beräkningskapacitet, eftersom rådatan sparas och transformationerna kan köras om som kod. ETL passar bättre när målet har begränsad kapacitet, när komplexa regler kräver en specialiserad motor eller när data måste maskeras eller granskas innan den landar. Många plattformar kombinerar båda.
Vad är skillnaden mellan ETL och en datapipeline?
En datapipeline är varje automatiserad kedja av steg som flyttar data från en plats till en annan och bearbetar den på vägen. ETL är ett specifikt mönster för en sådan pipeline: extrahera, transformera och sedan ladda. ELT, strömmande flöden och reverse ETL är andra mönster. Varje ETL-process är alltså en datapipeline, men alla datapipelines är inte ETL.
Är dbt ett ETL-verktyg?
dbt är ett transformationsverktyg, inte ett komplett ETL-verktyg. Det sköter transformationssteget inne i datalagret eller lakehouse-plattformen med SQL-modeller, tester och dokumentation, vilket gör det till en typisk ELT-komponent. Det extraherar inte data från källsystemen, så det används tillsammans med ett verktyg för inläsning eller replikering och ofta en orkestrerare som schemalägger körningarna.
Behöver vi ett separat ETL-verktyg om vi använder Microsoft Fabric?
Ofta inte för grunderna. Fabric innehåller pipelines, kopieringsjobb och notebooks i Data Factory för inläsning och transformation, så många team börjar med det som finns i plattformen. Separata verktyg kan ändå vara motiverade för källor utan lämplig anslutning, för change data capture från operativa databaser eller när teamet föredrar transformationer som versionshanterad SQL med ett verktyg som dbt.